Alluxio 基于Amazon S3,完成 MLPerf Storage v3.0基准测试, 交出亮眼成绩单
随着 AI 算力加速器性能飞速迭代、大模型参数规模不断膨胀,模型 checkpoint 给存储系统带来巨大 I/O 压力。越来越多企业选择云对象存储作为 AI 数据集持久化底座,但对象存储原生性能短板,往往会拖慢昂贵 GPU 集群,影响训练效率。
在最新 MLPerf Storage v3.0 测试中,Alluxio 验证了一套成熟且可落地的架构方案:全量 AI 持久化数据集保留在 Amazon S3 对象存储,同时在 GPU 计算侧部署分布式缓存层,为 AI 集群提供高性能的数据访问通路。
本次测试采用本地 NVMe 作为缓存介质:Alluxio 支撑 32 个模拟 NVIDIA B200 加速器运行 RetinaNet 训练任务,支撑 8 个模拟 B200 加速器运行 3D U‑Net 训练任务;针对 Llama 3 405B 千亿参数大模型 checkpoint 负载,实现147.03GiB/s 写入带宽、124.34GiB/s 读取带宽。这套软件定义存储架构,以对象存储作为真实数据源(source of truth),通过计算侧分布式缓存层补齐性能短板,无需将数据集迁移到独立的专用存储系统,如传统并行文件系统或 AI 专用存储一体机。
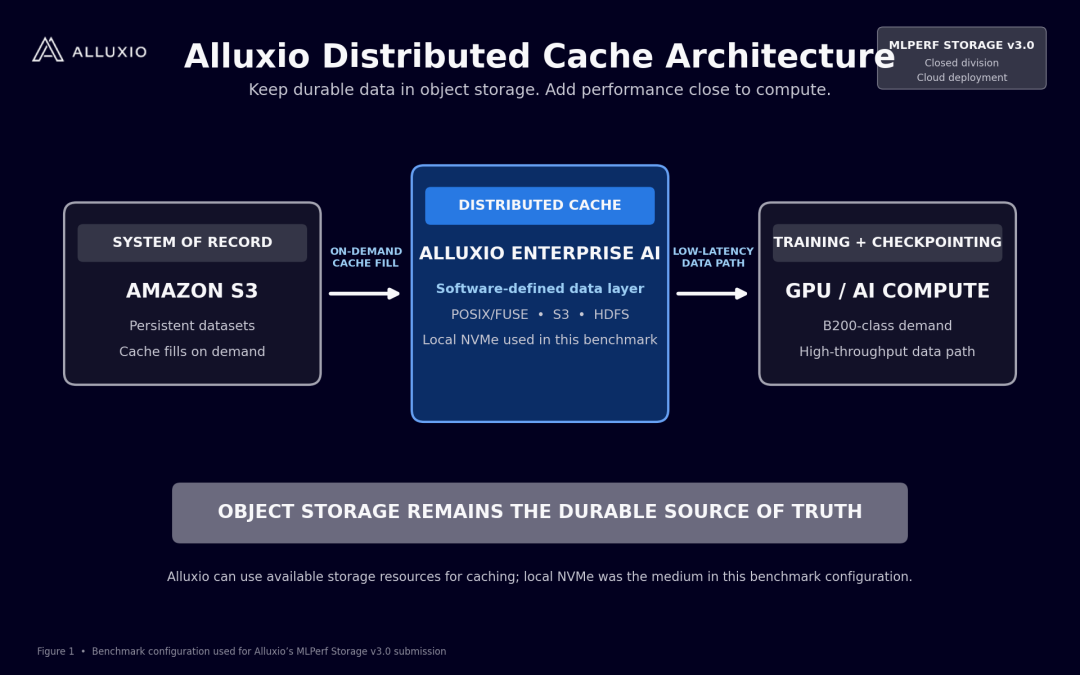
图 1:Alluxio 分布式缓存架构
MLPerf Storage v3.0:大幅提升现代 AI 基础设施的评判标准
MLCommons 推出的 MLPerf Storage v3.0,大幅扩展了 AI 存储基准测试的能力边界:同时兼容 POSIX 接口和 S3 对象存储访问,适配新一代 B200 级加速器,并支持参数量从低到高的 Llama 3 系列大模型 checkpoint 测试。对于大量基于云对象存储建设 AI 存储底座、追求 GPU 算力利用率最大化的企业来说,这份测试基准具有很高的参考价值。
在训练场景中,MLPerf 采用模拟加速器负载,不需要物理 GPU 硬件。v3.0 的有效结果必须满足加速器利用率门槛:3D U-Net ≥ 90%,RetinaNet ≥ 85%。checkpoint 测试分为两类核心链路:一类是会阻塞训练迭代的同步 checkpoint 写入链路,另一类是训练故障中断后用于恢复的 checkpoint 读取链路,覆盖 Llama 3 多档模型规格。
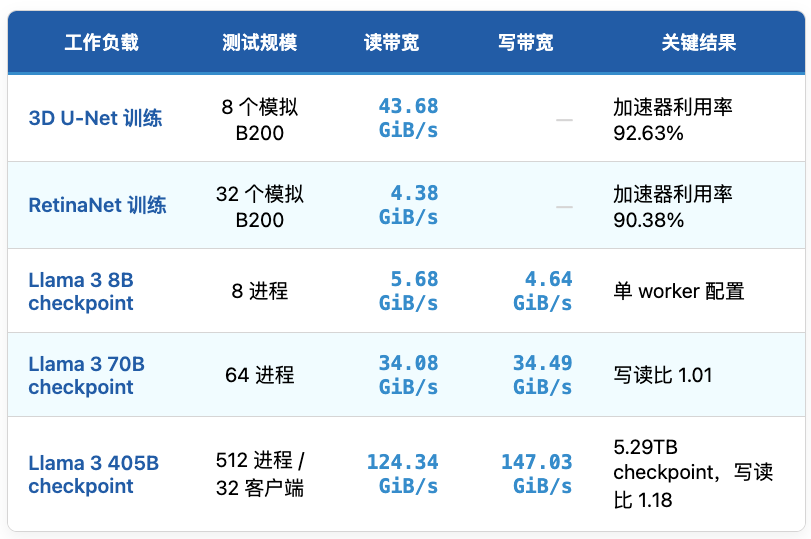
MLPerf Storage v3.0 – Alluxio 核心测试结果一览
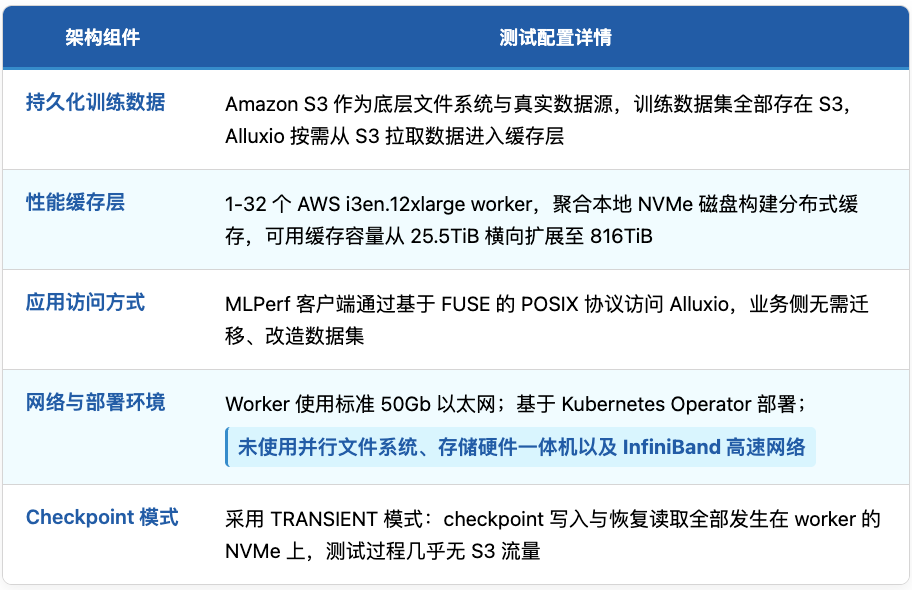
整套测试的数据流转链路非常清晰:Amazon S3 → Alluxio 分布式缓存层 → POSIX/FUSE → AI workload 客户端。Alluxio 部署在通用 AWS 云实例上,并通过 Alluxio Operator 部署在 Kubernetes 集群中。
大规模训练中,同步 checkpoint 是存储系统面临的巨大挑战:训练进程必须等待模型和优化器状态完整落盘,才能继续迭代;低速 checkpoint 会直接导致昂贵的 GPU 算力空转。
在 Llama 3-405B 测试负载下,512 个进程需要写入总计 5.29 TB 的 checkpoint 数据,对写入吞吐提出严苛要求。Alluxio 的测试结果达到 147.03 GiB/s 聚合写入带宽和 124.34 GiB/s 读取带宽;连续执行 10 轮完整 checkpoint 写入,单次平均耗时仅 37.5 秒。测试结果的写读带宽比达到 1.18,写入性能优于读取性能。在真实业务场景中,checkpoint 写入会直接阻塞训练流程,而读取主要发生在故障恢复场景,因此优先保障写入吞吐,对大模型训练业务更有实际价值。
这套性能表现依托于前文提到的软件定义架构:32 个云 worker、50 Gb 以太网,以及基于本地 NVMe 构建的分布式缓存层;整套环境没有使用专用并行文件系统、存储硬件一体机或 InfiniBand 高速网络。
Alluxio 单 worker 可实现 4.64 GiB/s 吞吐,扩容至 32 个 worker 后达到 147.03 GiB/s;worker 规模扩大 32 倍,吞吐提升 31.7 倍,达到理想线性扩展能力的 98.9%。对基础设施团队而言,这让容量规划变得可预测:模型规模增长时,只需同步扩容分布式缓存,无需推倒重构整套存储架构。
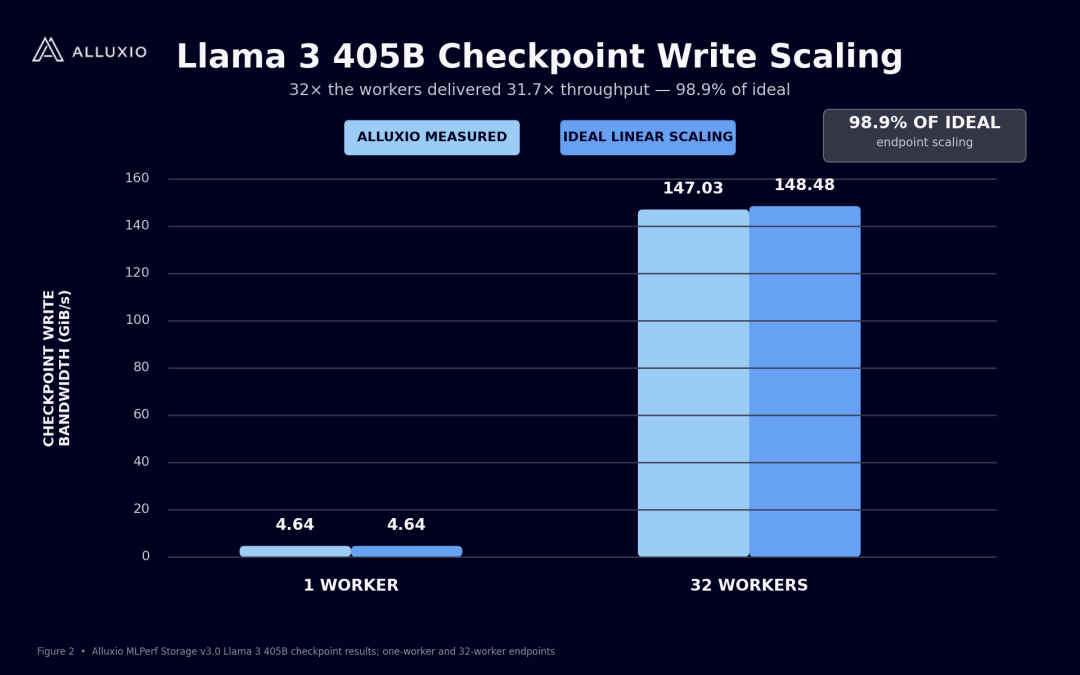
图 2:Llama3 – 405B checkpoint 写入扩展能力
AI 训练存储需要同时应对多种访问模式:3D U‑Net 以大文件顺序读为主;RetinaNet 需要处理数百万张小尺寸 JPEG 图片,对文件打开延迟、元数据操作、小 I/O 请求处理能力都提出了严苛考验。
在两种 I/O 模式下,Alluxio 每一轮计时测试全部达到 MLPerf 规定的加速器利用率门槛。
-
8 个模拟 NVIDIA B200 加速器运行 3D U‑Net:吞吐 43.68GiB/s,加速器利用率 92.63%;
-
32 个模拟 NVIDIA B200 加速器运行 RetinaNet:吞吐 4.38GiB/s,加速器利用率 90.38%。
针对海量小文件场景,在 650 万文件规模的数据集上,单存储节点可稳定实现每秒 14,564 次完整文件读取。
Alluxio 与 MLPerf Storage v3.0 其他参与测试方案对比
集群部署规模会极大影响整体聚合吞吐,因此单纯对比总吞吐,并不足以评判存储架构优劣。针对 Llama 3-405B 云环境部署的 5 套方案,由于客户端网络、可用容量和实现方式各不相同,我们重点关注两个更贴近业务价值的归一化指标:checkpoint 写读带宽比,用于衡量对阻塞训练的写入链路优化程度;每 TiB 可用容量的 checkpoint 写入带宽,用于衡量存储吞吐密度。
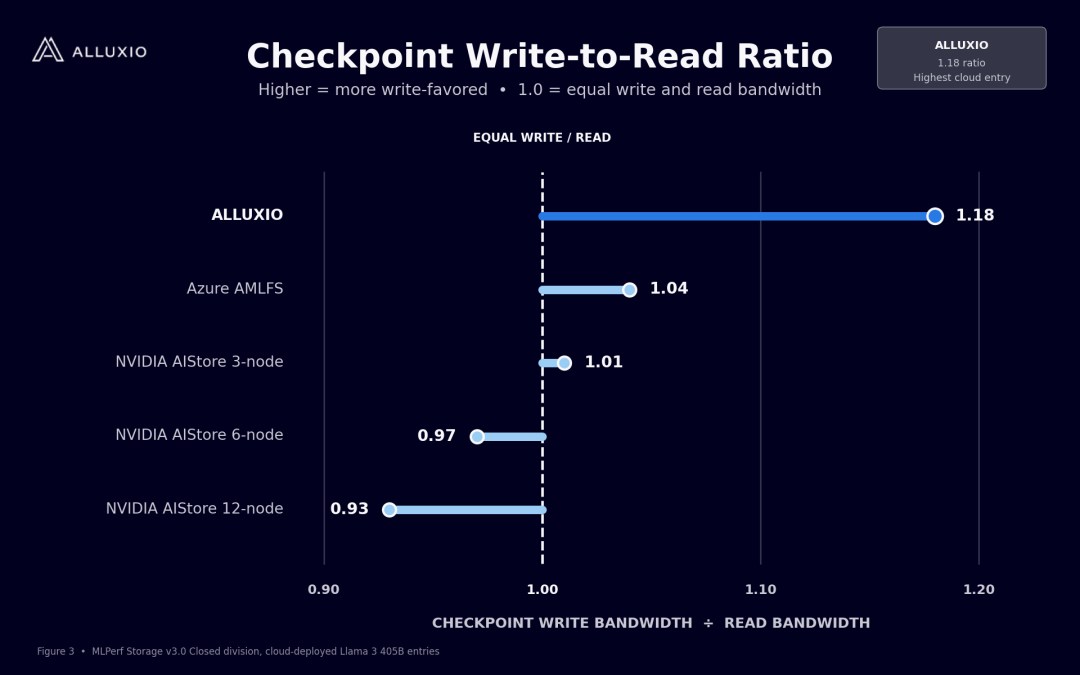
图 3:checkpoint 写读带宽比
在 5 个针对 Llama 3-405B 的云部署测试方案中,Alluxio 达到最高的写读带宽比。比值大于 1 代表写入速度高于读取;Alluxio 比值为 1.18,代表 checkpoint 写入比故障恢复场景的读取快 18%。由于同步 checkpoint 写入会暂停训练,而读取大多只发生在故障恢复阶段,因此写入优先的性能特征,远比读写性能完全均衡更有业务价值。
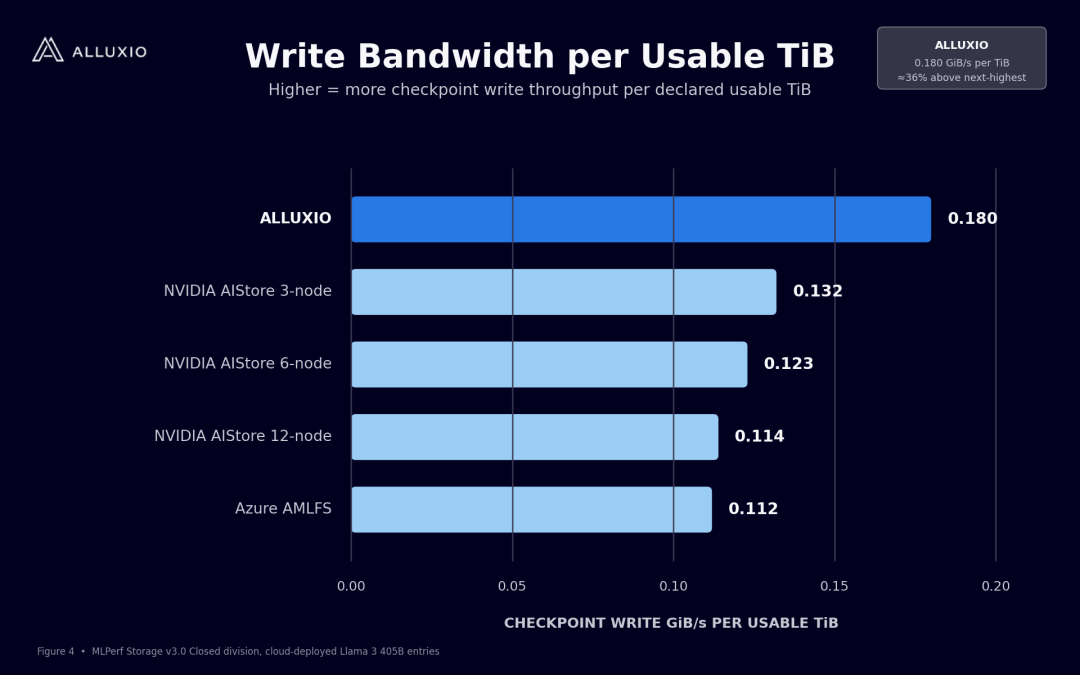
图 4:单位容量写入带宽对比
Alluxio 每 TiB 可用容量可输出 0.180GiB/s checkpoint 写入带宽,比第二名方案 0.132GiB/s 高出约 36%。
以上结果说明,Alluxio 的高性能并非依靠堆砌超大集群实现。在所有基于云部署的参测方案中,Alluxio 拥有最优的写入优先特性,以及最高的单位容量 checkpoint 写入带宽能力。
本文数据来源于 MLPerf Storage v3.0 Closed Division 针对 Llama 3-405B 的云部署方案测试结果。写读带宽比 = 官方公布 checkpoint 写入带宽 ÷ 读取带宽;单位容量写入带宽 = 官方公布 checkpoint 写入带宽 ÷ 申报可用容量。不同方案的硬件配置、网络和数据持久化模式存在差异;以上指标用于衡量写入链路倾向和吞吐密度,不代表成本、整机综合效率或端到端数据持久化时延。
Alluxio 架构价值与核心结论
MLPerf Storage v3.0 验证了业界主流 AI 存储架构思路:依靠对象存储承担数据持久化,在 GPU 计算侧叠加一层软件定义高性能分布式缓存。该架构无需将完整数据集迁移至独立高性能存储孤岛,保留对象存储低成本、高弹性的原生优势,同时满足 AI 严苛 IO 诉求。
这套架构为 AI 基础设施团队带来五大业务收益:
✓
对象存储作为真实数据源:训练启动前无需迁移完整数据集至独立高性能存储;
✓
性能下沉至算力就近位置:复用现有集群硬件资源,在 GPU 侧部署分布式缓存(本次测试采用本地 NVMe 介质),缩短热数据访问路径;
✓
存储能力随业务弹性横向扩展:依托 98.9% 的线性扩展效率,模型规模增长仅需扩容缓存节点;
✓
多协议兼容,上层业务零改造:持久数据保留于对象存储,业务可通过 FUSE‑POSIX、S3、HDFS 多种接口访问;
✓
提升 GPU 集群投入产出比:更快的数据加载、更快的 Checkpoint 落盘,降低 GPU I/O 等待闲置时间,让算力更多投入模型计算。
对于已经把云对象存储作为 AI 底座的企业,选型的核心并不是放弃对象存储换取高性能,而是引入一套可横向扩展的数据加速层,兼顾对象存储易用、低成本、灵活的优势,同时支撑 B200 级训练持续读请求,以及数 TB 规模 Checkpoint 突发 IO 压力。