AI 数据正从文本扩展到图片、视频和机器人轨迹等多模态内容。Lance 是面向多模态 AI 的开源湖仓格式,其列式文件格式针对随机访问和对象存储设计,并通过表与索引格式支持数据的增删改查、检索和训练读取,形成从数据管理到检索与训练读取的完整链路。
当多个任务并发检索、查询和读取海量图片、视频片段与机器人轨迹时,密集的数据访问请求容易累积为 I/O 等待。Alluxio 通过标准 S3 API 接入 Lance 的存储路径,作为对象存储前的透明加速层,将反复访问的热数据缓存在靠近计算的 Worker 节点上,供多个任务共享。应用无需改动 Lance 读写代码,只需调整 S3 endpoint,在这些场景中获得更快更高效的数据访问。
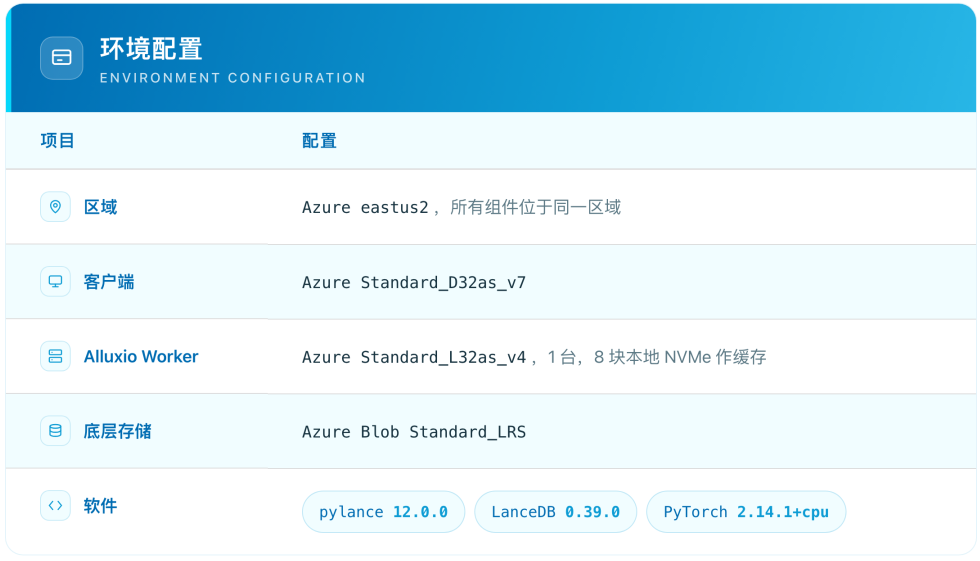
本文基于 Azure eastus2 的单台 Alluxio Worker 实测,覆盖检索、视频取帧、机器人数据、训练批次和海量小 fragment 场景,展示两者结合后的加速效果。下文将依次介绍实测结果、工作原理与接入方式。
本文作者:Leo Song、Tom Fu
Lance 应用接入 Alluxio,只需修改 S3 endpoint ,读写逻辑保持不变。在 Azure eastus2 的实测中,6 项 AI 读取任务的热读性能均优于直连 Azure Blob。热读指缓存已预热时的读取。
✓
图片向量检索和图片训练批次的加速比分别达到 13.14倍和 5.19倍。
✓
缓存为空时,仍有 5 项任务获得约 1.5~2.3倍的加速。
✓
尾延迟改善更为显著:图片向量检索的 p99 从 164.4 ms 降至 9.3 ms。
✓
在含 1 万个小 fragment 的表上,热读吞吐为直连的 2.0~6.5倍。
以上结果均基于单台 Alluxio Worker 取得。
多模态任务实测:热读最高加速 13.14 倍
本章选取 6 项典型的多模态 AI 读取任务,覆盖向量检索、混合检索、视频取帧、机器人数据读取和训练数据加载。所有任务均对比直连 Azure Blob 与经 Alluxio 访问的性能。
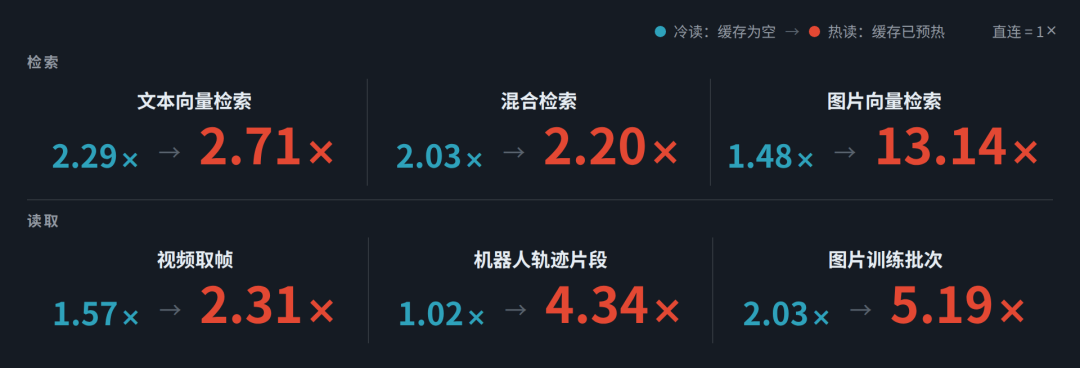
图 1|6 项读取任务相对直连对象存储的加速比
每项任务测试三种访问路径。每种路径运行 5 轮,取中位数。图 2~4 中,圆点为各轮数值。
✓
直连:Lance 通过原生 Azure 客户端直接访问 Azure Blob。
✓
冷读:Worker 缓存为空,客户端经 Alluxio S3 API 执行任务。
✓
热读:缓存已预热。先完整执行一次同一任务,再使用新的客户端进程计时。
本文面向多模态检索、训练数据读取和海量小 fragment 场景。所有性能数据均以同一任务直连 Azure Blob 的结果为基线。
文本向量检索
✓
负载:MS MARCO 数据,串行执行 1,000 次 Top-5 查询。查询向量预先生成,不计入耗时。
✓
查询方式:Lance 在 384 维向量列上执行 nearest 查询,参数为 nprobes=4、metric=cosine。
✓
耗时:总耗时从直连的 15.17 秒降至热读的 5.60 秒。加速比为 2.71 倍,冷读为 2.29 倍。
✓
单次延迟:单次查询的 p99 从 60.4 ms 降至 11.4 ms。
混合检索
✓
负载:MS MARCO 数据,串行执行 1,000 次 Top-5 查询。
✓
查询方式:LanceDB 合并向量检索和全文检索的排名。
✓
耗时:总耗时从直连的 22.43 秒降至热读的 10.22 秒。加速比为 2.20 倍,冷读为 2.03 倍。
✓
说明:对 RAG 应用而言,收益体现在检索候选段落并读取内容这一环节。本次测试不包含生成模型的推理延迟。
图片向量检索
✓
负载:在 DocVQA 表上执行 1,000 次 Top-5 查询。每轮读取 5,000 张完整 JPEG,约 2.88 GB。
✓
范围:测试不包含图片解码和 OCR。
✓
耗时:总耗时从直连的 58.13 秒降至热读的 4.42 秒。加速比为 13.14 倍,冷读为 1.48 倍。
✓
单次延迟:单次查询的 p50 从 46.4 ms 降至 2.7 ms。p99 从 164.4 ms 降至 9.3 ms。
✓
说明:该任务同时涉及检索和大媒体对象读取,因此缓存复用的收益最大。
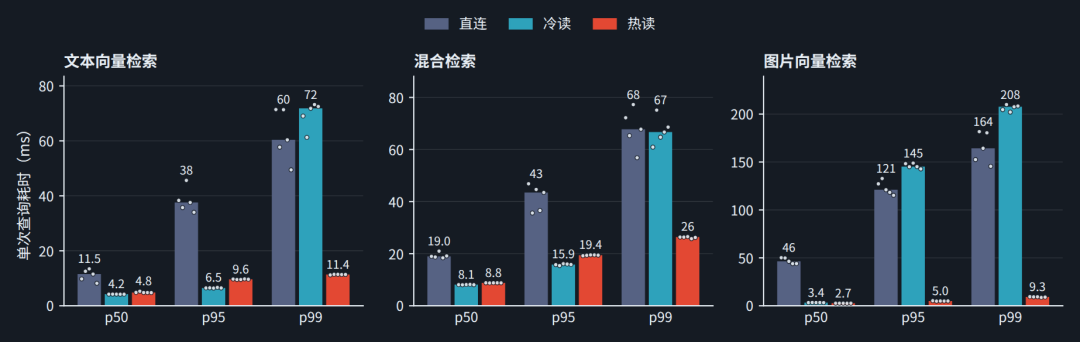
图 2|三类检索的单次查询延迟
视频取帧
✓
负载:从 OpenVid 的 100 段视频中各提取中间连续三帧。
✓
读取方式:Lance 通过 take() 获取时长和帧率,通过 take_blobs() 读取视频。PyAV/FFmpeg 仅解码所需帧。
✓
耗时:总耗时从直连的 30.68 秒降至热读的 13.27 秒。加速比为 2.31 倍,冷读为 1.57 倍。
✓
单次延迟:单段视频的 p50 从 303.4 ms 降至 128.2 ms。
机器人轨迹片段
✓
负载:从 32 段机器人操作记录中截取 128 个轨迹片段。每个片段包含连续八个采样时刻的状态和动作,以及三路相机共 24 帧。每轮合计 3,072 帧。
✓
读取方式:通过 take() 和 take_blobs() 读取数据,再解码并按时间对齐。
✓
耗时:总耗时从直连的 32.72 秒降至热读的 7.64 秒。加速比为 4.34 倍,冷读与直连持平。
✓
单次延迟:单个片段的 p50 从 234.9 ms 降至 46.7 ms。p95 从 364.6 ms 降至 73.8 ms。
图片训练批次
✓
负载:从 BDD100K 读取 1 万张图片及标注。每批 4 张,共 2,500 批。任务不包含模型训练。
✓
读取方式:两个 PyTorch 数据加载进程用 Pillow 解码并转换为张量。
✓
耗时:总耗时从直连的 167.36 秒降至热读的 32.26 秒。加速比为 5.19倍,冷读为 2.03倍。
✓
单次延迟:主进程获取下一批数据的 p95 从 154.7 ms 降至 13.1 ms。p99 从 223.8 ms 降至 14.1 ms。
✓
说明:缓存既缩短了整轮数据准备时间,也减少了训练循环等待输入的时间。
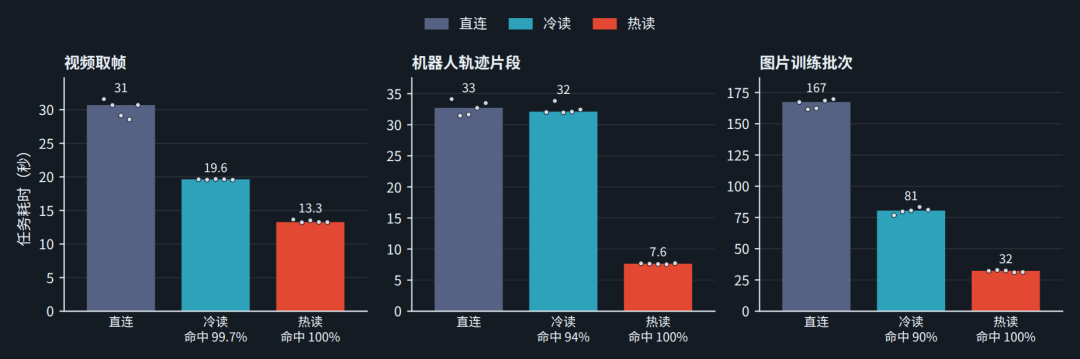
图 3|三项读取任务的总耗时
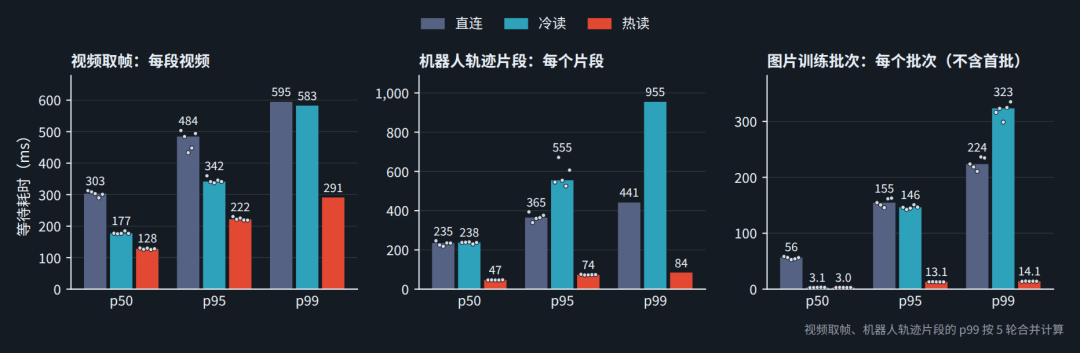
图 4|三项读取任务的单次等待耗时
海量小 fragment 实测:热读最高加速 6.5倍
频繁追加会让 Lance 表积累大量小 fragment,读取时产生密集的小对象请求。本组测试验证 Alluxio 能否承载这类负载。
测试表含 1 万个 fragment,每个 100 行。pylance 通过 S3 API 直接访问 Alluxio Worker。对照组为直连 Azure Blob。测试依次进行单客户端读取和并发读取。
✓
单客户端读取:对 1 万 fragment 的原表和 compaction 后的表,分别测试打开表、全表扫描和随机 take()。compaction 指将小 fragment 合并为大文件。
✓
并发读取:并发客户端数从 1 逐级增至 256,记录 fragment/s 吞吐和 p99。测试使用单台 Worker。冷读和热读分别对应空缓存和预热后的访问。
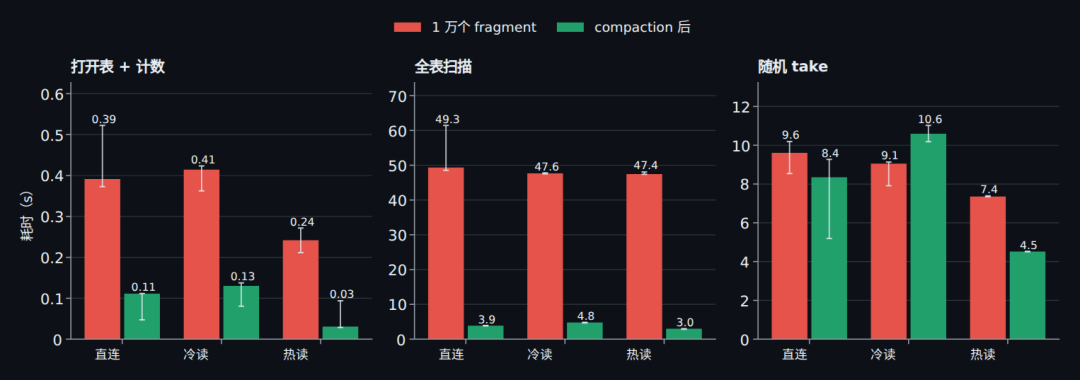
图 5|单客户端读取耗时
单客户端全表扫描时,三种路径耗时均为 47~49 秒。热读使打开表耗时减少约 40%。compaction 后,热读打开表的加速比超过 3 倍,随机 take() 耗时减少约 45%。合并小 fragment 与缓存命中共同改善了离散访问性能。
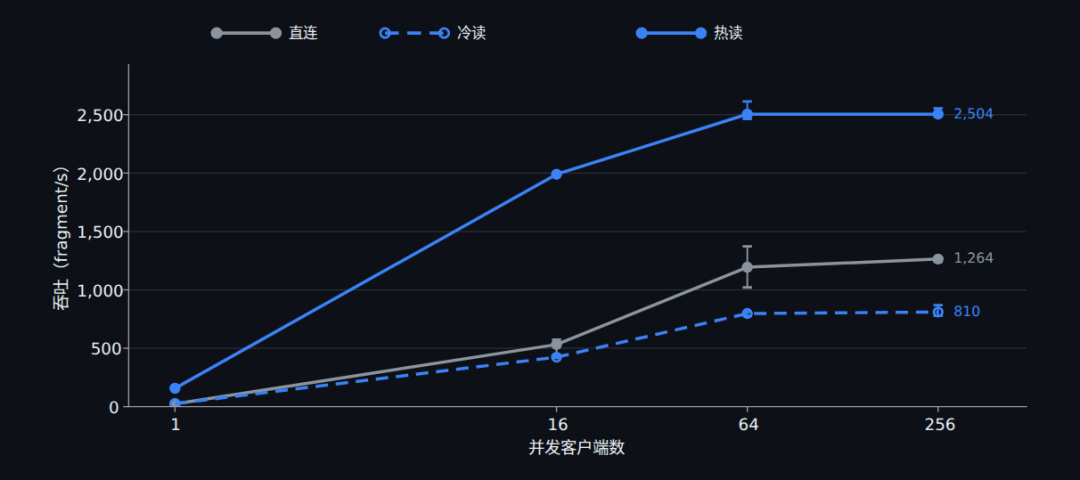
图 6|并发读取吞吐
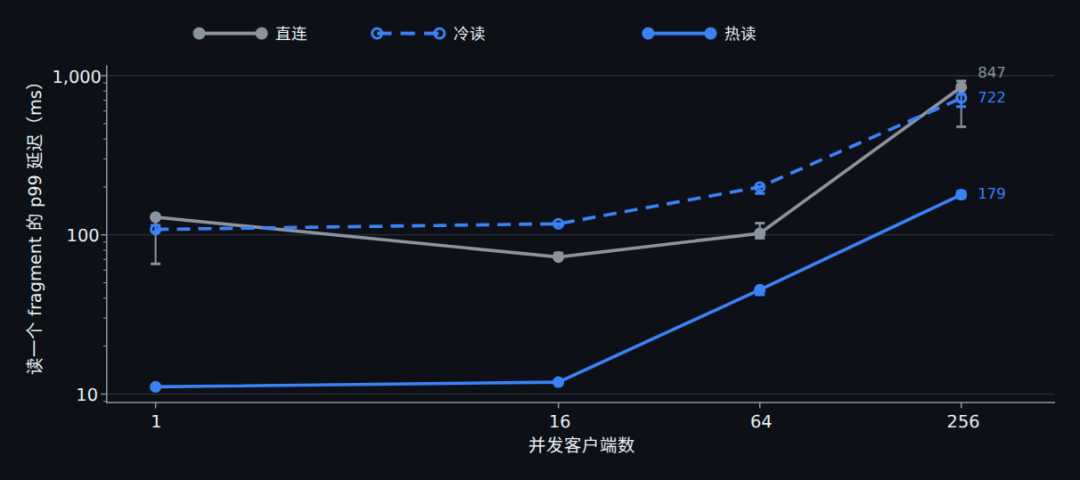
图 7|并发读取 p99 延迟
并发读取是本组测试中收益最显著的部分。 热读吞吐在并发 64 时达到约 2,500 fragment/s。在各档并发下,热读吞吐为直连的 2.0~6.5 倍。并发不超过 16 时,热读 p99 约 11 ms,直连为 70~130 ms。并发 256 时,热读 p99 为 179 ms,直连为 847 ms。
多个客户端反复访问同一批 fragment 时,Alluxio 从靠近计算端的缓存返回数据。密集小对象请求的延迟因此大幅降低。
Lance:面向多模态 AI 的开放湖仓格式
前两章的收益,源于 Lance 的访问模式与 Alluxio 缓存的契合。本章从存储视角介绍 Lance 的数据组织方式和读写路径。
Lance 不是单一的 .lance 文件,而是一组相互协作的规范。官方规范将存储侧划分为文件、表、索引和 catalog 四层。本文涉及前三层:
✓
文件层:管理列、页和编码,支持按列、按行和按范围读取。
✓
表层:以 fragment、manifest 和版本管理快照。不可变的数据文件构成可提交、可回溯的版本。
✓
索引层:单独维护标量、向量和全文索引。
🔗 参考:
Lance 格式总览:https://lance.org/format/
文件格式:https://lance.org/format/file/
表格式:https://lance.org/format/table/
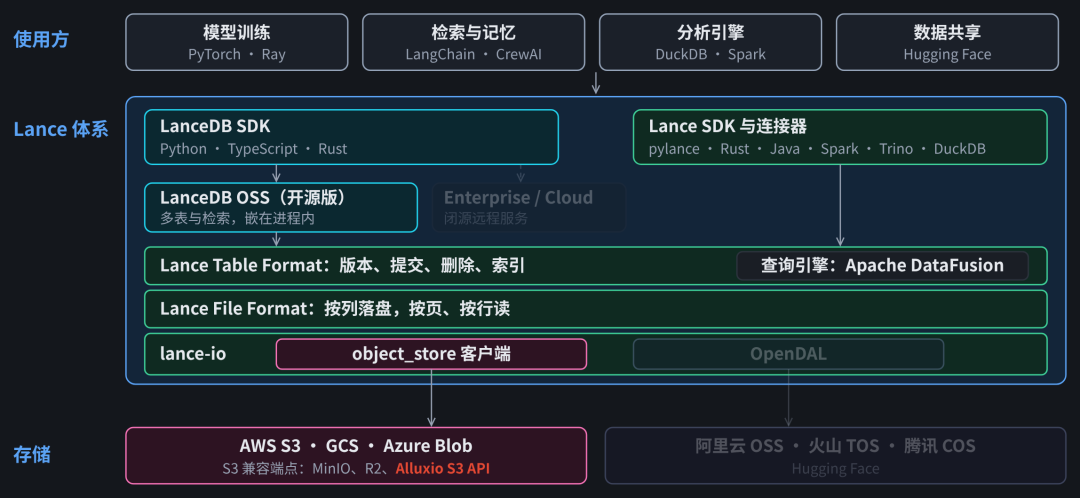
图 8|Lance 生态分层与 Alluxio 接入位置
LanceDB SDK 和 Lance SDK 最终均通过 lance-io 访问存储。Alluxio S3 API 作为 S3 兼容端点,由 lance-io 的 object_store 客户端访问。
Lance 表按行划分为多个 fragment。每个 fragment 可包含多个数据文件,每个文件存储部分列。manifest 记录当前版本引用的 fragment、删除文件和索引。
因此,追加行、补充 embedding 列、删除记录和创建索引均无需重写整张表。这些操作只写入新对象,再提交新版本。检索时先通过索引定位候选行,再按需回表读取正文或媒体数据。
🔗 参考:
表格式:https://lance.org/format/table/
索引格式:https://lance.org/format/index/
以示例表 photos 为例,共六个步骤。前五步为写入:建表、追加 100 行、补充 embedding 列、创建索引、删除一行。第六步为查询。
每次写入仅新增对象,并发布新的 manifest。旧版本对象保持不变,因此已打开的读取方可继续访问原有快照。
🔗参考:
Lance读写与版本:https://lance.org/guide/read_and_write/
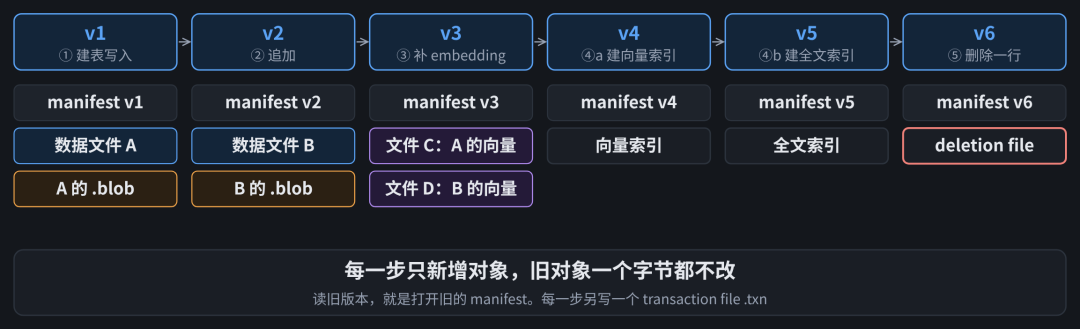
图 9|示例表每一步新增的对象
建表时先把较大的图片按大小写成 .blob 对象,再写入 .lance 数据文件。写入 300 行共发出 15 个 S3 请求。最后一个请求通过条件 PUT 发布 manifest。
追加操作生成新的 fragment。补充 embedding 列时只读取 caption 列,并为每个 fragment 写入新列文件。向量索引和全文索引分别提交新版本。删除操作仅写入 deletion file。
manifest 记录 schema、fragment、文件和索引。它的文件名按版本倒序编号,版本越新数字越小,因此 LIST 返回的第一个即为最新版本。
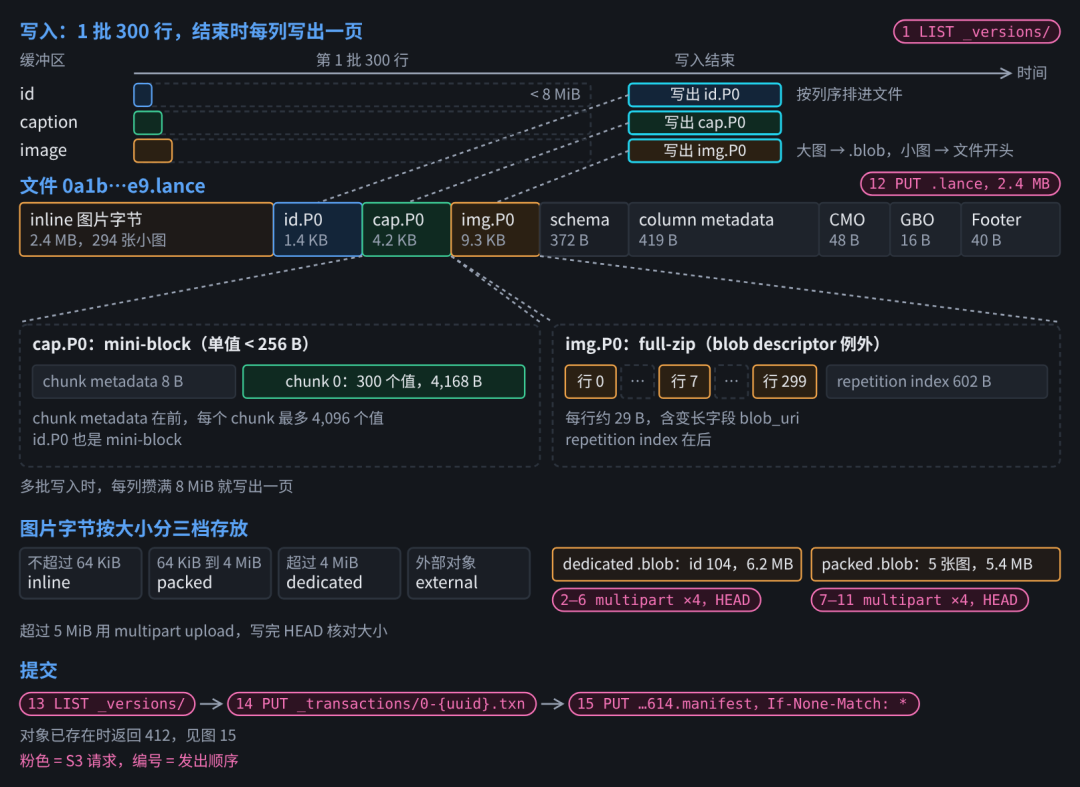
图 10|建表时的文件布局与请求顺序
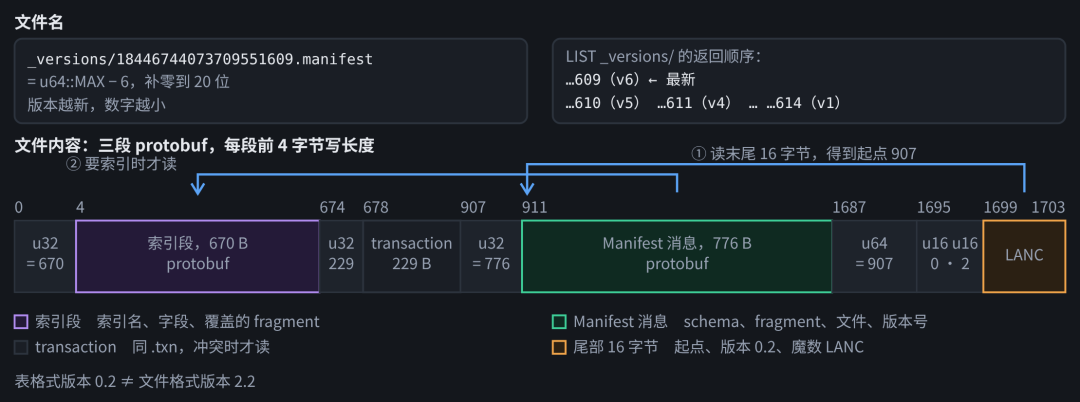
图 11|manifest 的布局与版本定位
Lance 的读取高度精准,但请求数量多、单次数据量小。示例查询共发出 23 个 S3 请求,读取的列数据仅约 15 KB。访问远端存储的往返延迟因此逐次累加。
Lance 进程内仅缓存文件尾等元数据,不缓存数据页和图片。同一次查询会两次读取 caption 页。此外,进程内缓存无法跨进程共享。
图 12 是示例查询的读取路径:先扫描 caption 列定位命中行,再读取四张图片。
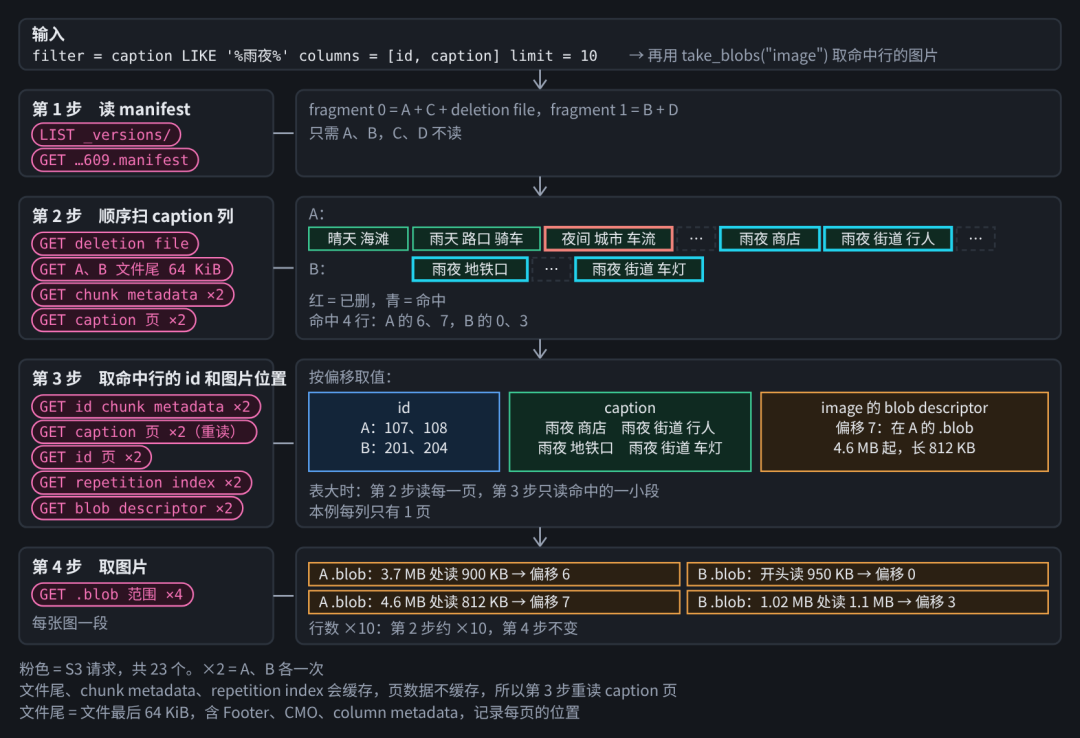
图 12|示例查询的四步读取路径
表变大时,扫描只读取相关列的页。按行取值时,读取范围从文件尾逐层收窄到 chunk、行和图片字节。
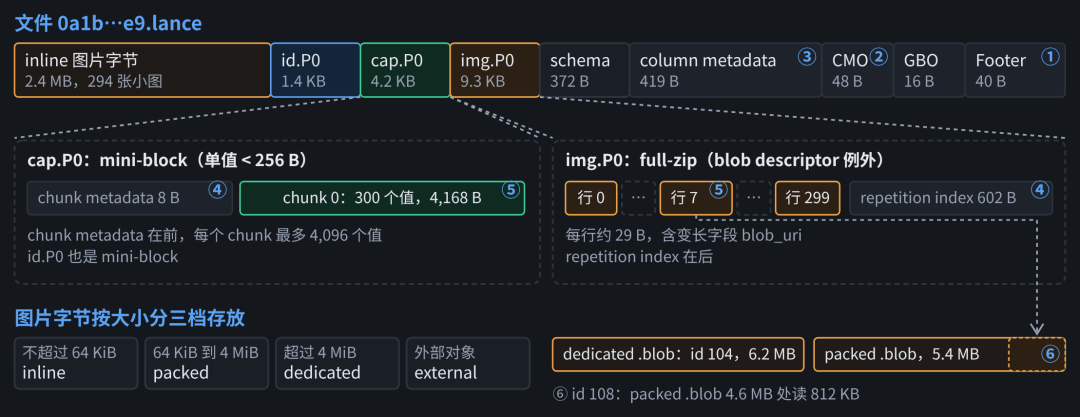
图 13|按行读取的逐层定位
Alluxio 作为独立的数据服务层,承接这些重复的数据请求。已读取的数据缓存在靠近计算端的 Worker 上。实测中,热读使用新的客户端进程计时,缓存字节命中率仍为 100%。这表明多个任务和进程可以共享同一份缓存。
零改动接入:应用继续使用 Lance API
Lance 原生支持 S3 兼容对象存储。接入 Alluxio 后,应用仍调用 lance.dataset()、lance.write_dataset(),或 LanceDB 的 connect()、open_table()。只需修改两处:
✓
表 URI 指向 Alluxio 挂载点。
✓
storage_options 中的 aws_endpoint 指向 Alluxio S3 API。
Lance 继续负责过滤、索引和解码,Alluxio 承接对象访问和缓存。
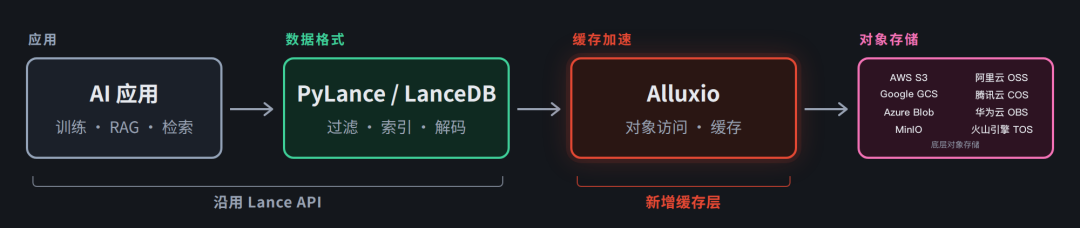
图 14|Alluxio × Lance 集成架构
import lanceimport lancedb
opts = {"aws_endpoint": "http://worker:29998","allow_http": "true","aws_access_key_id": "alluxio","aws_secret_access_key": "alluxio",}
# PyLanceds = lance.dataset("s3://my-mount/datasets/photos", storage_options=opts)
# LanceDBdb = lancedb.connect("s3://my-mount/datasets", storage_options=opts)tbl = db.open_table("photos")
示例中,my-mount 为 Alluxio 挂载点,worker:29998 为 S3 API 地址。实际地址和凭证请按部署环境配置。LanceDB 的 URL 指向库目录,表名由 open_table() 指定。
🔗 参考:
Lance 对象存储配置:https://lance.org/guide/object_store/
Lance 发出的均为标准 S3 请求,包括 LIST、GET 和范围 GET、PUT、HEAD、分片上传和条件 PUT。Alluxio S3 API 接收这些请求,由 Worker 访问后端存储并提供缓存。本次验证的后端存储为 Azure Blob。
Lance 通过一次条件 PUT 提交版本,请求携带 If-None-Match: *。两个写者同时提交同一版本时,后到的一方收到 412。Lance 随后读取对方的事务记录,确认兼容后自动 rebase,并提交下一个版本。
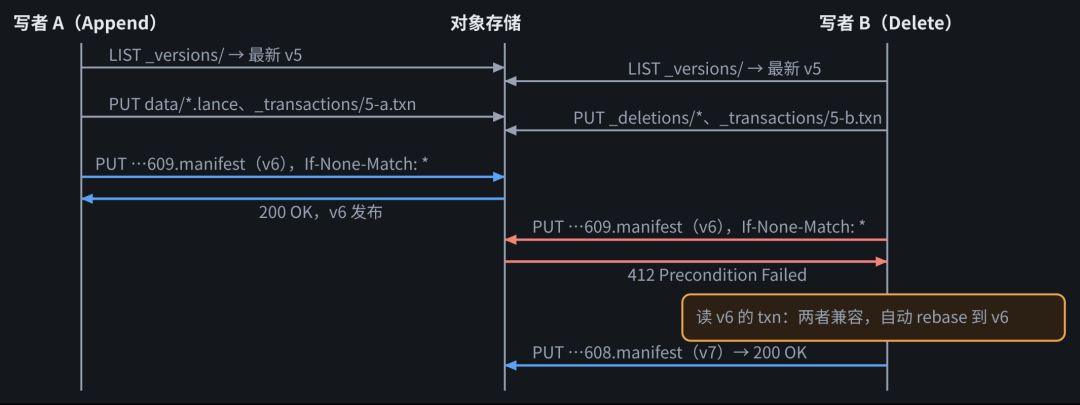
图 15|并发提交时的条件 PUT 与自动 rebase
小结:在数据访问路径上发挥 Lance 的随机访问优势
Lance 在同一张表上完成向量检索、回表、媒体读取和版本提交。Alluxio 通过 S3 API 接入,应用无需改变 Lance 的使用方式。重复访问的数据由 Alluxio 缓存就近提供。
对 AI 工作负载而言,重复访问的图片、视频、机器人数据和训练批次收益最为明确。热读时,6 项读取任务均快于直连。图片向量检索和图片训练批次的加速比分别达到 13.14 倍和 5.19 倍。
在海量小 fragment 场景中,Alluxio 的价值尤为突出。重复读取已缓存的数据时,热读吞吐为直连的 2.0~6.5 倍。
参考文章: